1. 物理封装与芯片微架构:Chiplet 对称布局
昇腾 950 采用 多 Die Chiplet 合封架构,包含 2 个 AI Die、2 个 IO Die 及高速内存模块,通过 D2D Clink 和 Memory Interface 组成统一内存访问(UMA)的整体。
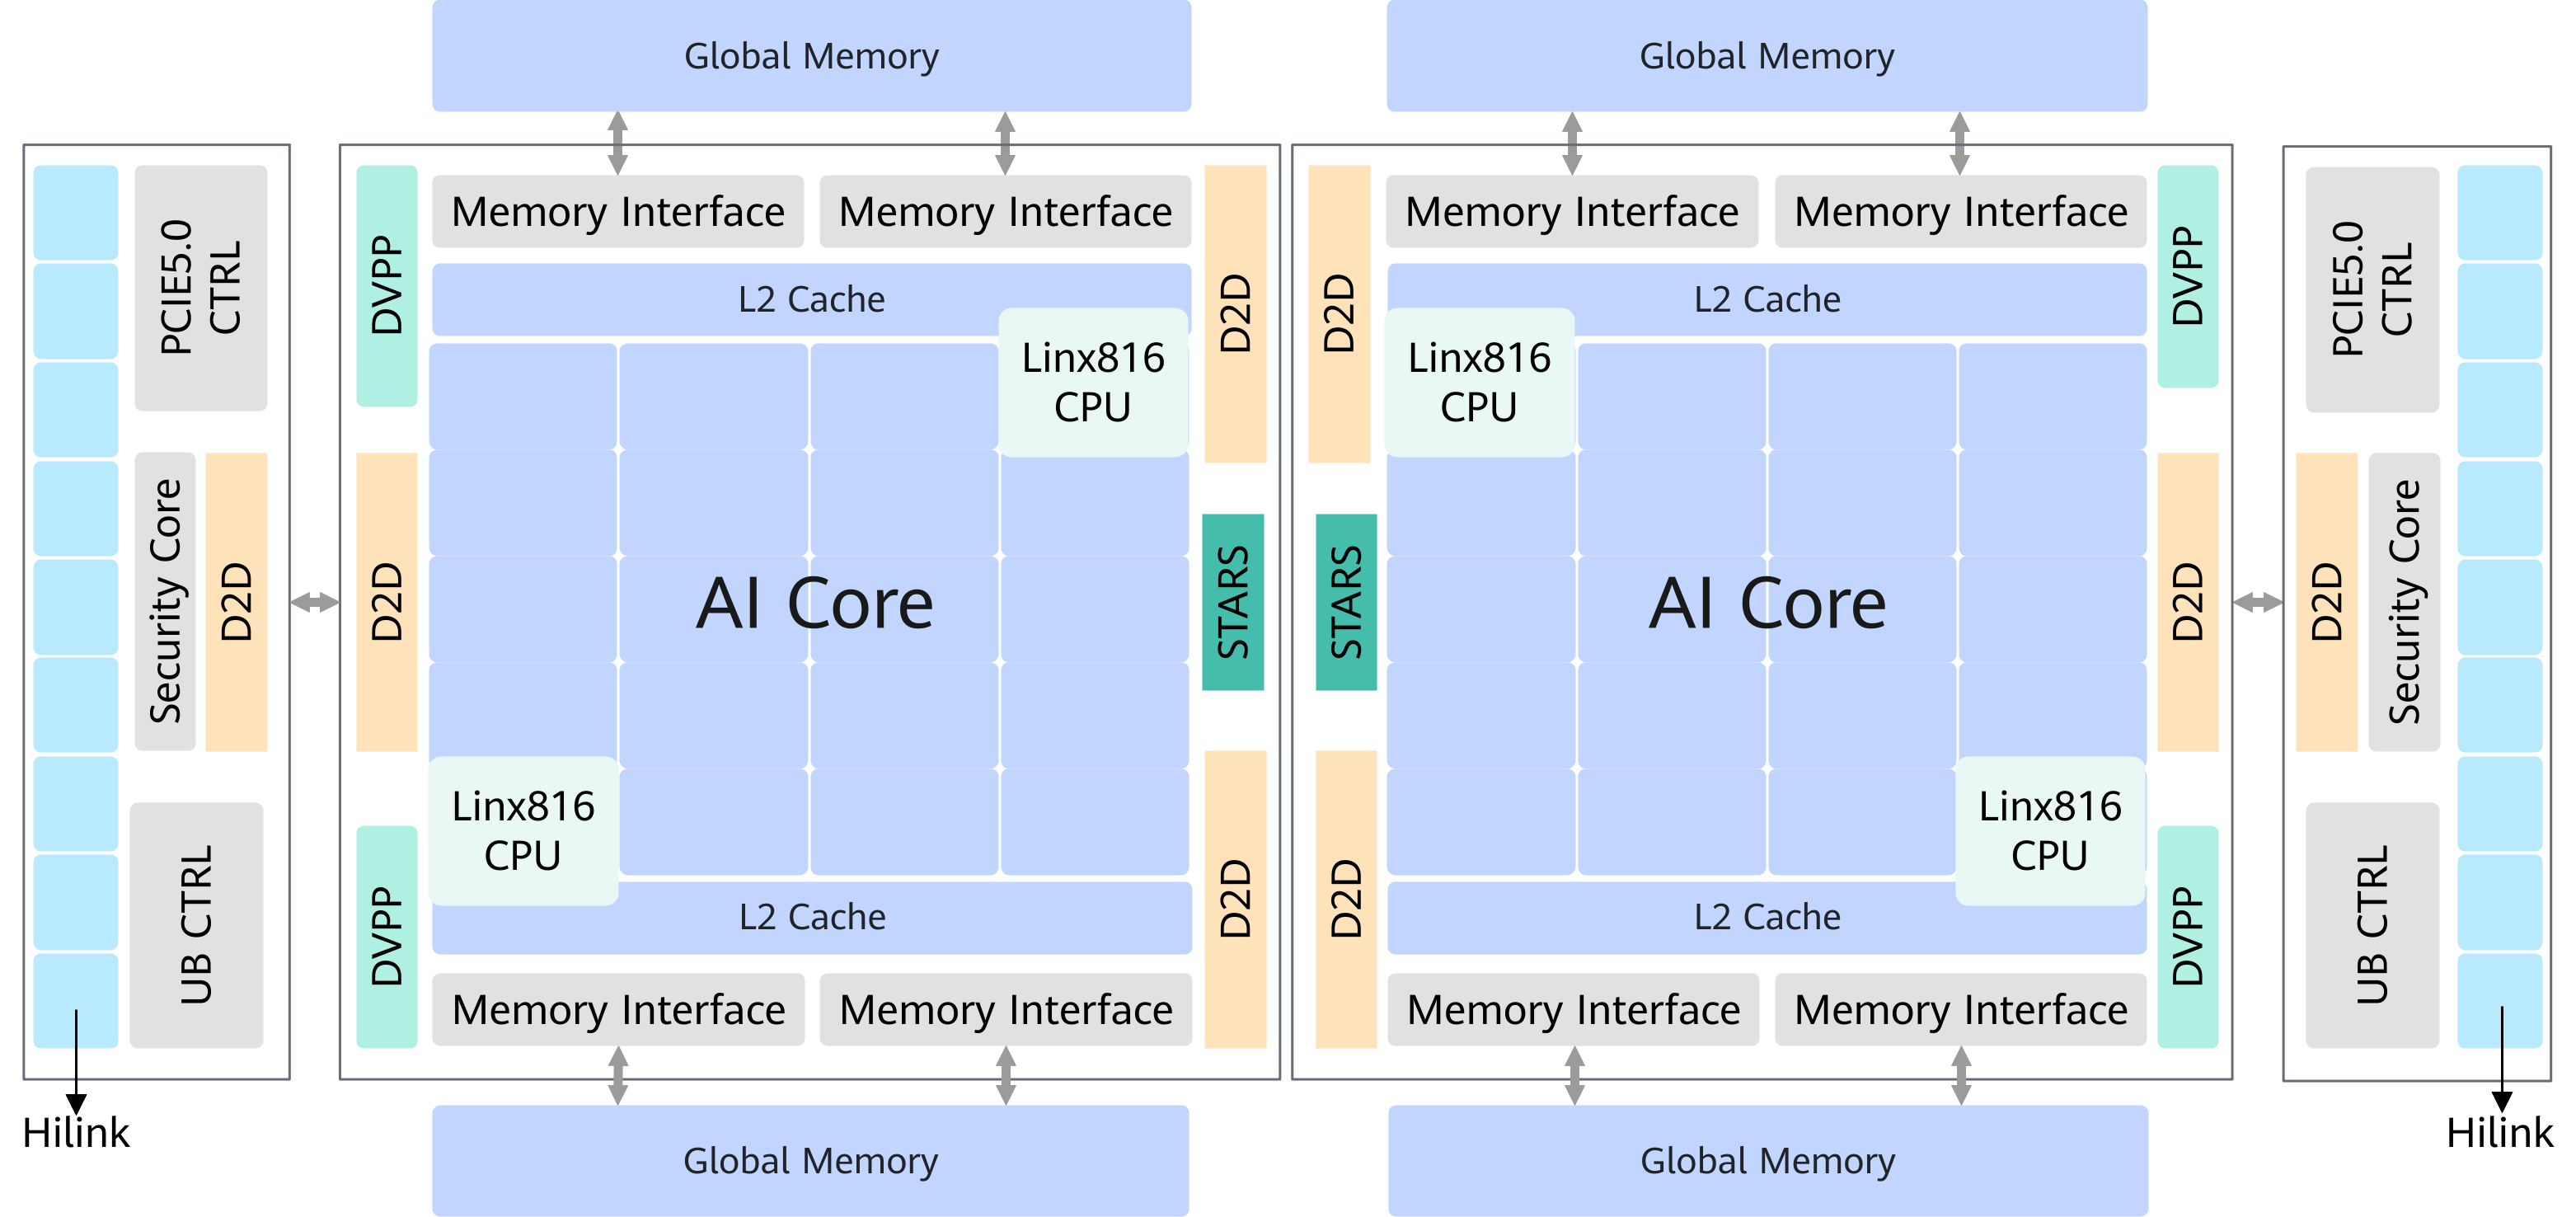
图 3-1 昇腾 950 芯片架构示意图(来源:《昇腾 950 NPU 架构白皮书》)
-
横向晶粒排布(左至右):
- 左侧 IO Die:集成 9 个 X4 Port HiLink(36 Lane)、UB 控制器、PCIe 5.0 控制器及安全核心。
- AI Die 0(主计算晶粒):集成完整的 AI Core 阵列、Linx816 AI CPU、L2 Cache 及硬件一致性目录(Directory)。
- AI Die 1(主计算晶粒):结构与 AI Die 0 镜像对称。
- 右侧 IO Die:集成另外 9 个 X4 Port HiLink(36 Lane),与左侧 IO Die 镜像互补。
-
上下包夹的 Global Memory(GM):
- 芯片顶部与底部各画出 4 个 Memory Interface(MI),整芯片合计 8 个;每个 AI Die 上下各 2 个。
- 950PR 合封 8 个高速内存模块,950DT 合封 4 个。
-
片内互联(D2D)与片上走线逻辑:
- 跨 AI Die(Die 0 Die 1):通过 D2D Clink 互联,支持跨 Die 访问与硬件维护的 L2 Cache 一致性。每个 AI Die 都画有 STARS 模块;HSCB 是 STARS 与计算资源交互的专用高速控制总线。D2D 方框表示晶粒间接口。
- 跨 IO Die 穿行机制:跨侧路径可按
IO Die 0 → D2D → AI Die 0 的片上互联 → D2D → AI Die 1 的片上互联 → D2D → IO Die 1理解。On-Chip Switch 支持同一 IO Die 内 9 个端口之间的转发。
2. 存储层次与微观调度:SRAM vs DRAM 及 STARS 流水线
完整架构包含 36 个 AI 子系统,每个由 1 个 Cube Core + 2 个 Vector Core 组成;另有 4 个 AI CPU Cluster(每个 2 个双线程 Linx816 CPU、4 MB L3)和 4 个 DVPP 子系统。950PR/950DT 的具体 SKU 存在资源裁剪。
2.1 存储介质、层级与可见范围
Unified Buffer(UB) 是核内局部存储;Unified Bus(UB,灵衢) 是互联体系。
- SRAM:典型单元采用 6T 结构,无需周期性刷新,延迟低但单位容量面积较大。核内 L1/L0 Buffer、Unified Buffer 和片上 Cache 等属于这一类存储。
- DRAM:典型单元采用 1T1C 结构,需要刷新,适合大容量存储。Device GM 与 Host DDR 属于这一层。
- L2 Cache:完整规格为 128 MB,跨两个 AI Die 统一访问,硬件维护两 Die 的缓存一致性,但保留局部亲和性。图中上下分布的 4 个 L2 区域组成统一地址空间,内部采用多 Bank 结构,512 B Cache Line,支持 128 B Sector。
Unified Buffer/L1/L0 属于核内局部存储。跨 Die 交换中间结果时,通过全局地址交接,再由消费方加载到自己的局部存储。Cube L1 与 Vector Unified Buffer 的直接 CV 通道则属于 AI 子系统内部的数据复用能力。
AI Core 的局部 Buffer ↔ 搬运单元 ↔ L2 / 片上互联 ↔ MI ↔ GM
                                              ↕ D2D
                                    对端 Die 的全局存储访问路径
生产者与消费者通过任务依赖协调数据就绪和缓冲复用。访存优化包括 Die 亲和性、L2 hint 和 SDMA 的 CMO(预取、写回、无效化、冲刷)。
2.2 任务流(Stream)、Task 与 Kernel 的分工
STARS 2.0 是全芯片的任务与资源调度中心,支持 Host 向 Device 下沉 2048 条任务流。它根据任务流配置预取、调度任务并上报结果,由软硬件协同完成。
任务流涉及三个对象:
- Stream:任务的有序提交与执行上下文;支持最多 2048 条任务流。
- Task 描述符:描述任务类型、执行入口、参数和资源配置等控制信息。
- Kernel 代码与参数:由软件装载和管理,目标计算核在派发后执行。
Host / CANN:准备代码、参数和任务,提交任务流
          ↓
STARS:按配置预取 → 检查依赖 → 选择资源 → 派发
          ↓ HSCB(面向 AIC/AIV 的专用控制通路)
目标引擎:执行计算或搬运 → 上报完成状态
          ↓
STARS / 运行时:推进任务流,满足后续任务的依赖
STARS 可调度 AIC、AIV、AI CPU、DVPP、SDMA、UB 和 CCU 等资源;公开并发规格包括 64 个 UB Jetty、32 个 CCU 任务、32 个 SDMA 通道。
2.3 同步分层:STARS 事件与 BufferID
| 层级 | 机制 | 负责什么 |
|---|---|---|
| 多任务流、异构引擎之间 | STARS 同步标志位 | 前序任务通知、后序任务等待,串接计算与通信的数据依赖 |
| AI Core 内部流水线 | BufferID:get_buf() / rel_buf() | 表达流水线对内部存储的占用与释放,类似加锁/解锁 |
| 跨卡通信 | URMA 完成记录与通知等 | 判断搬运完成及对端数据就绪,再衔接后续任务 |
STARS 支持最多 128K 个单比特或 4096 个 32 比特同步标志位。BufferID 负责核内流水线同步。
STARS 还支持最多 8 个 Group,可按 Die 划分计算资源做亲和性调度,以利用本地 L2。
3. 物理接口、SerDes 端口复用与双向带宽
整芯片左右两侧 IO Die 共提供 72 Lane HiLink SerDes,划分为 18 个 X4 Port,总物理双向带宽为 2.016 TB/s(标称约 2.0 TB/s)。
整芯片共享 SerDes 资源:18 个 X4 Port(72 Lane)
   ├─ PCIe 5.0 x16:启用时占用 4 个 X4 Port
   ├─ UBoE 2 × 400G:启用时占用 2 个 X4 Port
   └─ 原生 UB:使用其余端口,数量随配置变化

同时启用 PCIe 与 UBoE:18 − 4 − 2 = 12 个原生 UB Port
3.1 端口物理复用机制
- UBoE 复用(2 个 X4 Port):整芯片共用 2 个 X4 Port,静态复用为 400Gbps Ethernet Link,双向提供 200 GB/s()接入通用以太网交换机。
- PCIe 5.0 x16 复用(4 个 X4 Port):PCIe x16 消耗 4 个 X4 Port 的底层物理 SerDes 资源,双向提供 128 GB/s(单向 64 GB/s)。
3.2 端口速率的计算标准(448G vs 400G)
- 原生 HiLink / UB 协议(448 Gbps/口):跑灵衢私有协议时,单 Lane 运行最高 112 Gbps 物理线速率,单 X4 Port 双向物理带宽折合约 112 GB/s()。整芯片 18 个口双向聚合即为 2.016 TB/s(约 2 TB/s)。
- UBoE 模式(400 Gbps/口):400GbE 是以太网标称速率,单口双向折合 100 GB/s,两口为 200 GB/s。
4. 传输协议栈辨析:UB Memory、URMA 与 PCIe
| 协议形态 | 访问原语与语义 | 软件/硬件行为 | 典型适用物理拓扑 | 典型应用场景 |
|---|---|---|---|---|
| UB Memory | Load、Store、Atomic(AtomicLoad / AtomicStore / Swap / CAS) | 同步访存语义;Core 发出操作,Memory Decoder 解析目标,对端 UMMU 完成地址翻译与权限校验。 | 超节点内部(机框内直连或经 UB Switch 互通);超大共享 CPU 内存池。 | • 推理超长上下文离散 KV Cache 读取;• 推荐系统海量稀疏 Embedding 表检索;• 全局原子锁与分布式任务同步。 |
| URMA (UB Remote Memory Access) | Write、Read、Send、带通知操作、FetchAdd / CAS | 异步非阻塞/大块搬运;对标传统 RDMA。经 Jetty 提交请求并写 Doorbell,由 URMA 硬件执行,通过完成记录或配置的通知衔接后续工作。 | • 超节点内部(HiLink 原生链路,CTP/RTP 模式);• 跨超节点/数据中心(经 UBoE 封装跑在以太网交换机上)。 | • 训练大张量梯度/激活值复制; • MoE 专家路由(All-to-All);• CCU 集合通信加速引擎的底层载体(AllReduce/AllGather 等)。 |
| PCIe 5.0 | 标准 TLP 事务层(PCIe DMA / BAR MMIO) | 标准外设总线协议;独立协议栈,不是原生 UB Memory / URMA 数据通路;Host 仍可经 PCIe 配置设备和提交通信任务。 | 主要连接 Host 与 Device;P2P 能否使用取决于平台拓扑和软件支持。 | • Host 到 Device 的模型参数初次加载(H2D/D2H);• 传统 CPU 主机驱动控制指令下发。 |
4.1 访问语义、承载与加速引擎
UB Memory 与 URMA 是访问语义,HiLink 是高速互联底座,UBoE 是 UB 的以太网承载方式,PCIe 是另一套总线协议,CCU 则是集合通信卸载引擎。
细粒度共享访存 ── UB Memory ─────────── 原生 UB 链路 / UB Switch
异步搬运与消息 ── URMA ─────────────── 原生 UB 或 UBoE / 以太网
集合通信任务   ── CCU ─┬─ URMA 搬运 ── 上述通信路径
                      └─ Reduce Unit 规约计算
主机交互       ── PCIe DMA / MMIO ──── Host 与 Device
URMA 提供类似 RDMA 的异步远程内存访问能力,以 Jetty 为通信入口。
超节点内部同时支持 UB Memory 和 URMA。URMA 可通过 UBoE 接入以太网,由交换机转发至对端 NPU 等兼容通信端点。
4.2 URMA:提交、执行、完成与数据落点
- 准备与提交:软件建立通信资源,配置可访问内存与权限;AI Core、AI CPU 或 STARS 通过 Jetty 队列入口提交请求,并通过 Doorbell 通知硬件。
- 异步执行:请求描述源/目的地址、长度及操作等信息,硬件负责搬运。提交后可重叠执行无依赖的计算,搬运完成后释放相关缓冲区。
- 完成与通知:SQE 是请求描述符,CQE 是完成记录。本端通过完成记录获取执行状态,对端通过 ImmediateData 或 Notify 等机制接收通知,并衔接后续任务。
- 消费数据:典型跨卡数据落在 GM,再由消费核搬到自己的局部 Buffer;CCU 路径还支持远端节点与本端 DRAM 或 MemorySlice 之间的搬运。
URMA 的 RTP 模式支持端到端可靠重传及多路径,提供 4 Port 带宽能力;CTP 提供简易传输服务,不支持端到端可靠重传,提供 9 Port 带宽能力并支持多路径。
4.3 CCU:基于 URMA 的集合通信卸载
CCU 接收系统调度器下发的集合通信任务,执行软件预置的通信算法程序。CCUM 管理 Mission 任务,CCUA 提供 MemorySlice 存储和 Reduce Unit 计算:搬运时调用 URMA,规约时调用计算单元,完成后通过 Mission 接口上报状态。
典型算法包括 Broadcast、ReduceScatter、AllGather、AllReduce、All2All 和 All2Allv。CCU 通过卸载降低 AI Core 的通信处理负担。
5. 全层级通信范围与双向带宽全景汇编
5.1 组网架构选型与端口分配
- 纯灵衢超节点模式(一种端口配置):卡上关闭 UBoE,18 个 X4 Port 中 4 个留给 PCIe 连主机,其余 14 个 Port 全跑原生灵衢协议(按每口 400 Gbps 单向计,双向合计 1.4 TB/s) 连入外部 UB Switch,出以太网由交换机侧做物理协议转换。
- Host-Free 配合原生 UB 组网:Linx816 AI CPU 独立承载 OS,PCIe 与 UBoE 全关,整卡 全部 18 个 X4 端口(双向 2.016 TB/s)完全释放给原生 UB。
- 无 UB Switch 的直连以太模式:启用 2 个 UBoE 端口(双向 200 GB/s) 直连以太交换机;若同时启用 PCIe x16,剩余 12 个端口用于原生 UB 互联。
Host-Free 模式由内置 AI CPU 承担控制任务,也可通过 UBoE 直接连接以太网。关闭 PCIe、保留两口 UBoE 时,原生 UB 剩余 16 口。
5.2 全层级通信与带宽总表
链路带宽统一采用双向聚合、十进制 GB/s 或 TB/s。GM 带宽按内存带宽标注:950PR 为 1.6 TB/s,950DT 为 4.0 TB/s。
单向 Gbps 转双向 GB/s 的公式为:单向速率 ÷ 8 × 2。因此 400 Gbps 单向对应 100 GB/s 双向,14 口对应 1.4 TB/s;若按每口 448 Gbps 原始线速,则 14 口为 1.568 TB/s。
| 通信层级与范围 | 物理介质 / 控制部件 | 核心承载协议 | 带宽与口径 |
|---|---|---|---|
| 单核内部数据流转 | Cube L1 Vector UB 直连通道 | 核内专用总线(BufferID 控制) | 白皮书未给出统一带宽数值 |
| 计算与控制核协同 | AI Core (L2) AI CPU (L3) | 片上 NoC + 硬件目录(Directory 一致性) | 白皮书未给出统一带宽数值 |
| 片内 GM 访存(950PR) | 8 个 Memory Interface (MI) | 挂接 L2 Cache 统一编址体系 | 最高 1.6 TB/s,内存带宽 |
| 片内 GM 访存(950DT) | 8 个 Memory Interface (MI) | 挂接 L2 Cache 统一编址体系 | 最高 4.0 TB/s,内存带宽 |
| 卡内跨 Die 互通 | D2D Clink | 128MB 全局 L2 Cache 一致性 | 白皮书未公开 D2D 带宽 |
| 单 IO Die 内部转发 | IO Die 内部局部 NoC 路由器 | UB On-Chip Switch | 单侧 9 个 X4 Port 之间转发;未单列交换带宽 |
| 单芯片全部 UB 端口的理论峰值 | 18 个 X4 Port HiLink (72-Lane) | 原生灵衢 2.0(UB Memory + URMA) | 2.016 TB/s(约 2.0 TB/s)双向 |
| 超节点跨框(单口) | 单个 X4 Port(受限于出框光模块) | 原生灵衢 2.0 | 100 GB/s 双向(按 400 Gbps 单向端口计算,具体受光模块约束) |
| 超节点跨框(单卡出框总计) | 14 个 X4 Port(扣除 PCIe 的超节点配置) | 原生灵衢 2.0 | 1.4 TB/s 双向(按 14 × 400 Gbps 单向计算) |
| 跨超节点大规模扩展 | 外部光纤 标准以太交换机 (UBoE) | URMA over Ethernet | 200 GB/s 双向() |
| 卡与 Host CPU DDR | PCIe 5.0 x16 插槽(占用 4 个 X4 Port) | PCIe 5.0 标准体系(DMA / MMIO BAR) | 128 GB/s 双向(单向 64 GB/s) |
容量与规模另看:950PR 最高 128 GB GM,950DT 最高 144 GB GM;完整架构 L2 为 128 MB,具体 SKU 可有裁剪。白皮书给出的 UB 超节点上限为 8192 卡,整体集群支持超过 128K 卡;支持最高 128 TB 的 Host–Device / Device–Device 内存共享访问。
基于 UB 还可挂接 CPU 内存池和存储资源池(白皮书 §4.7.2–4.7.3),利用远端资源缓解单卡容量限制。
参考资料:
- 《昇腾 950 NPU 架构白皮书》:图 3-1 与表 3-1(架构与规格);§4.1.4–4.1.6(CV、NDDMA、BufferID);§4.3–4.4(存储与调度);§4.6–4.7(互联与组网)。