昇腾 950 的架构变化可以按三条主线看:核内执行模型、跨子系统缓存边界、任务调度层级。第一条决定向量算子能跑多快,第二条决定 AI Core 与 AI CPU 如何共享数据,第三条决定任务如何从 Host 进入 NPU 并被各硬件单元消化。
本文按这三条主线梳理《昇腾 950 NPU 架构白皮书》中的关键信息,并从 AI 编译器视角解释这些设计对算子优化的影响。
1. 第三代 Vector Core 的性能来源
白皮书对第三代 Vector Core 的结论是:FP16 与 FP32 单核算力较上一版本提升 100%。这个提升是由寄存器堆、双发射、乱序执行和混合编程模式共同完成的。
1.1 Register-Based 执行层级
传统向量机器常见的一种组织方式,是让向量 ALU 直接面向较大的局部存储,例如 Unified Buffer(UB)。这种方式的优点是存储容量大、编程模型直观;代价是 ALU 的操作数供给容易被局部存储端口、地址生成和数据复用方式限制。
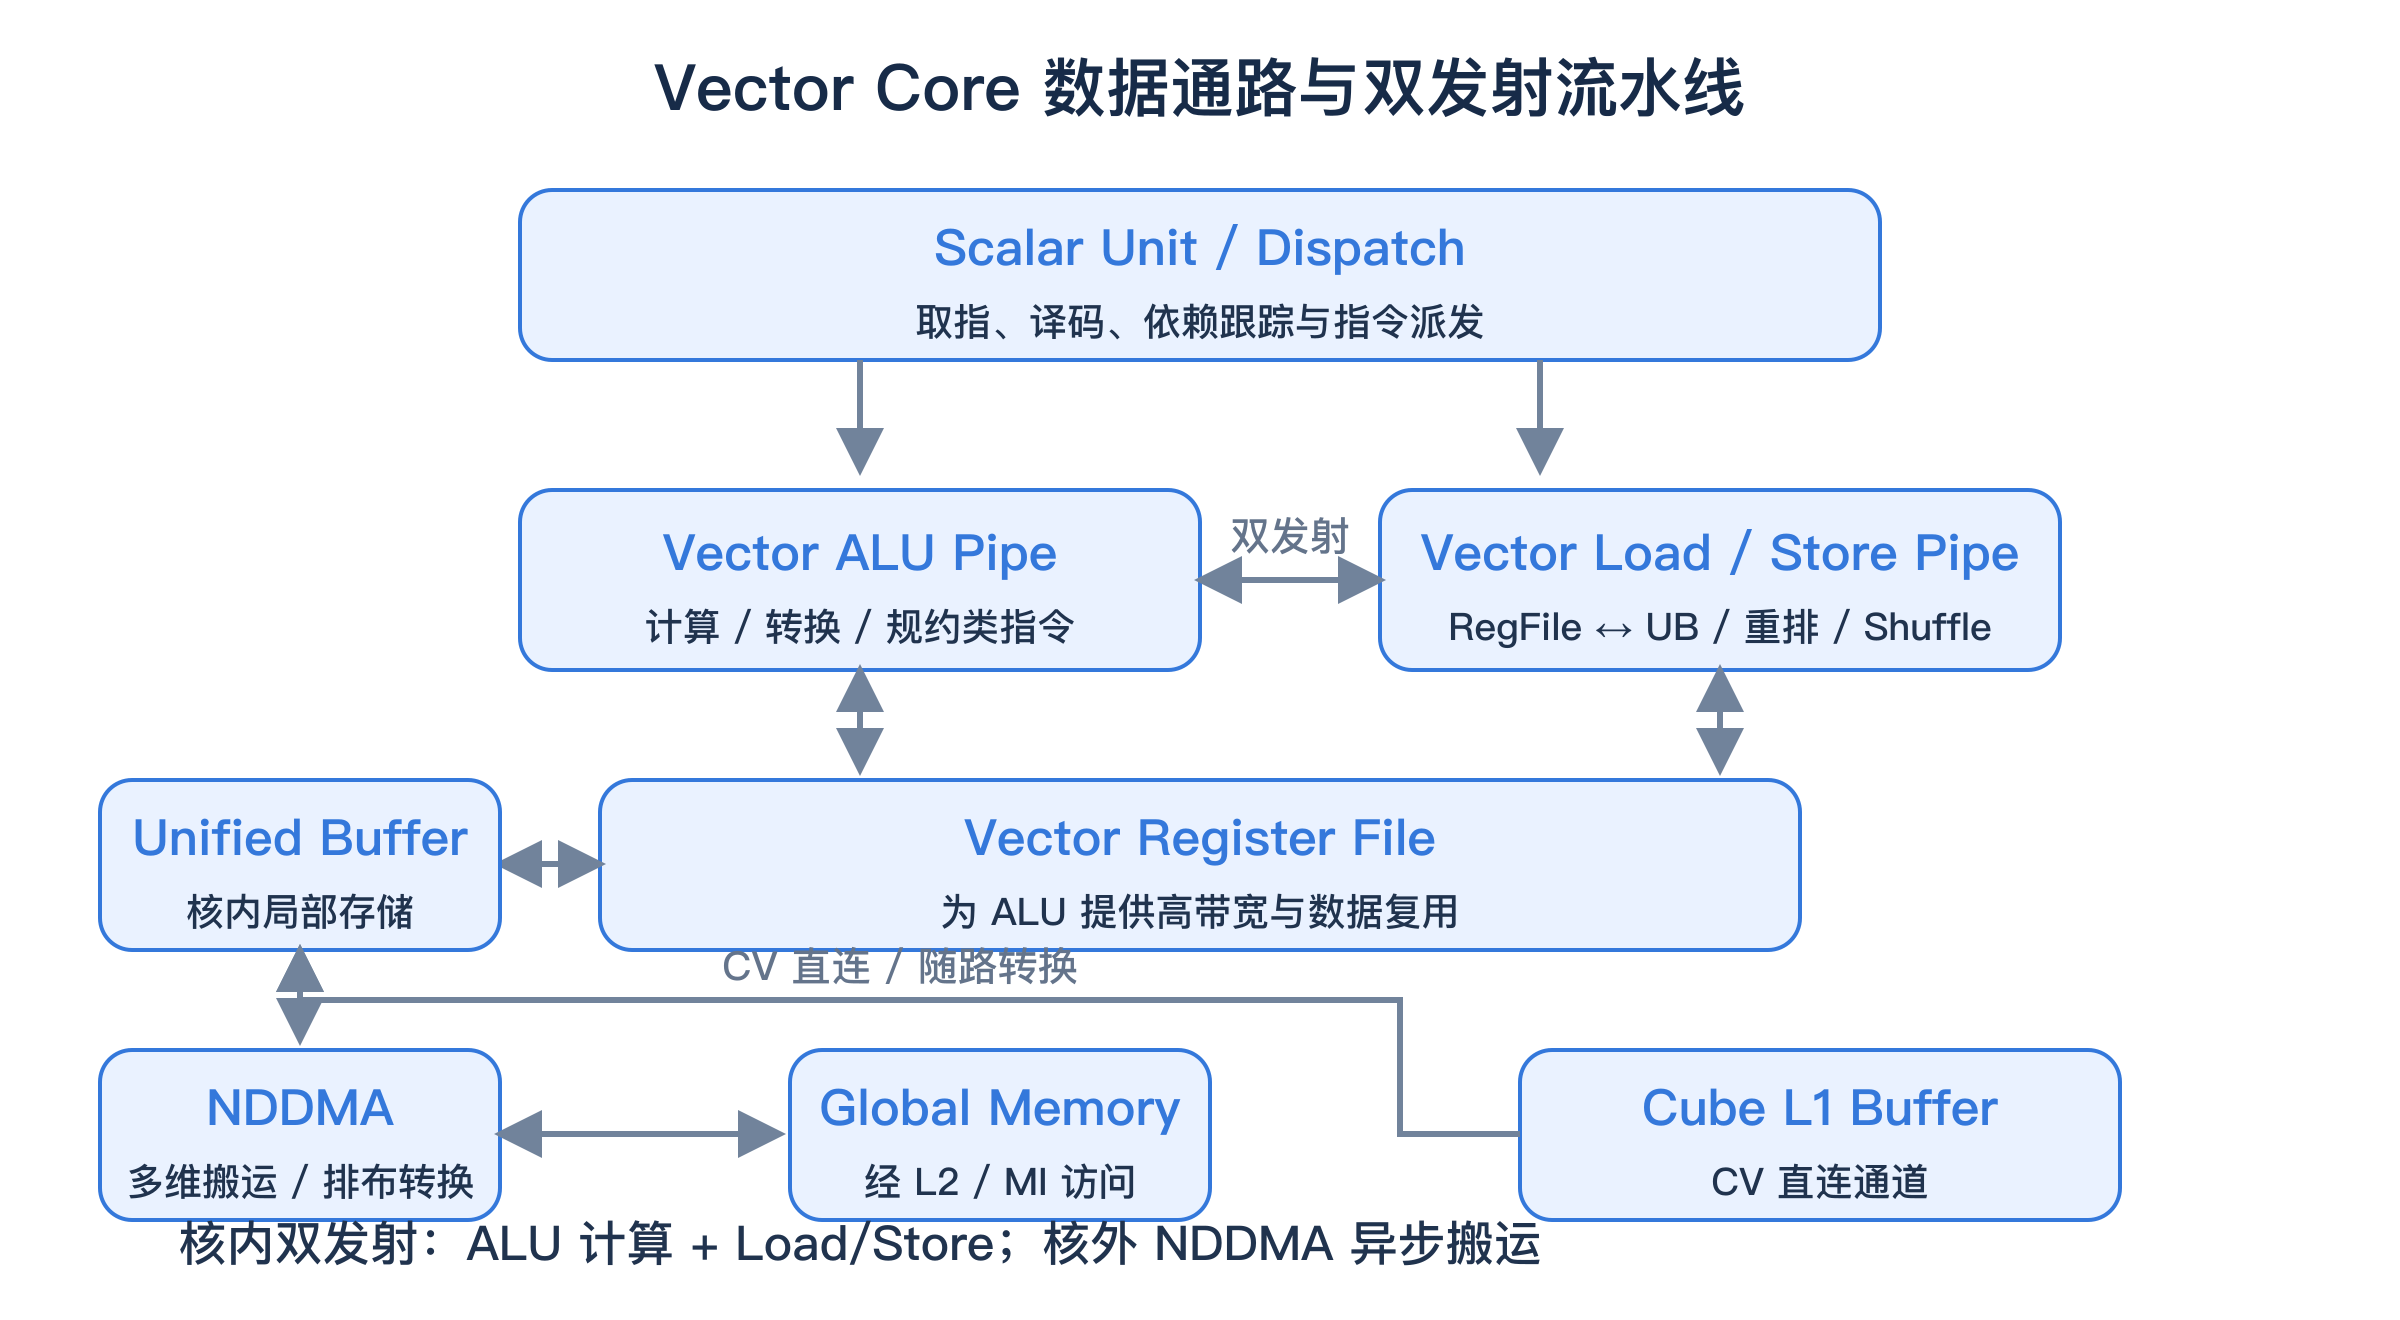
昇腾 950 在 Unified Buffer 与 Vector ALU 之间引入 Vector Register File,把寄存器堆作为执行过程的临时存储。白皮书将其价值总结为两点:
- 更高带宽支持:ALU 的读操作数和写回不再直接压在 UB 访问路径上;
- 更高数据复用能力:循环中的中间向量、累加状态和转换结果可以留在寄存器堆中。
这使 Vector Core 从“面向 UB 的向量执行”转向“面向寄存器堆的向量执行”。对算子作者来说,寄存器压力和 load/store 调度会变得更重要。
1.2 双发射与异步搬运的边界
白皮书 §4.1.3 提到,SIMD 借助**双发 ALU 指令与乱序执行(Out-of-Order Execution)**提升每周期吞吐。这里需要区分核内双发射与核外异步搬运:
- 核内双发射:向量执行流水线内,ALU 计算与 Load/Store 类访存/重排流水线可以并发推进。典型形态是同一周期发出一条向量计算指令,同时发出一条向量 load/store 或数据重排指令;
- 核外异步搬运:NDDMA 或通常所说的 MTE 类搬运引擎是独立异步引擎,负责 Global Memory、UB、L1 等存储层级之间的大块搬运,并不占用 Vector ALU 的算术发射槽位。
因此,950 Vector Core 的流水线可以概括为:
Scalar Unit / Dispatch
        │
        ├── Vector ALU pipe        # 计算、转换、规约类指令
        └── Vector Load/Store pipe # RegFile ↔ UB、重排、Shuffle

同时:NDDMA / MTE 在后台异步搬运大块张量
这解释了为什么 Register-Based 与双发射必须一起看:寄存器堆提供了近端操作数池,双发射让“准备下一批数据”和“计算上一批数据”可以重叠,NDDMA 再把更远端的搬运异步化。
1.3 面向 Softmax、GELU 等关键函数的微架构优化
FlashAttention 一类算子的难点,常常不是矩阵乘本身,而是矩阵乘之后的 Softmax、缩放、mask、exp、归一化和数据重排。如果 Vector 侧不够快,Cube Core 的矩阵算力就会被非矩阵部分拖住。
白皮书明确提到,950 针对 Softmax、GELU 等关键函数优化微架构,提高张量 ALU 利用率,减少数据依赖导致的流水线气泡,并在提升频率与算力的同时保持低指令延迟。配合 CV 融合通道,FlashAttention 单核性能较上一代提升 1.5 到 2 倍。
1.4 SIMD/SIMT 的分工
昇腾 950 采用“新同构 SIMD/SIMT 混合编程”。它不是把所有算子都切成 SIMT 线程,也不是让 SIMD 和 SIMT 随机切换,而是把基本函数块定义为 Vector Function(VF),每个 VF 可以选择以 SIMD 或 SIMT 方式实现,并支持快速切换。
选择原则很清晰:
| 算子特征 | 更合适的执行模式 | 原因 |
|---|---|---|
| 规则访存、element-wise、稠密向量计算 | SIMD | 双发 ALU 与乱序执行能最大化每周期吞吐 |
| Gather/Scatter、Hash Insert、复杂分支 | SIMT | 线程级执行降低不规则控制流和离散访存的编程复杂度 |
| 混合形态算子 | VF 分块选择 | 每一段按特征映射,兼顾性能与可编程性 |
这对编译器的含义是:不能只把 NPU 当成“宽 SIMD GPU”或“纯 SIMT GPU”。调度器和 lowering 需要识别算子片段的访存规则性与控制流复杂度,再决定 VF 的执行模式。
2. CV 融合与 NDDMA 的数据通路
昇腾 950 的 AI 子系统完整规格是 1 个 Cube Core + 2 个 Vector Core。Cube 负责 GEMM,Vector 负责 Softmax、激活、量化、数据重排等非矩阵部分。二者之间如果每次都要经过 L2 或 Global Memory,融合算子的收益会被搬运吃掉。
950 通过两条机制解决这个问题。
2.1 Cube L1 与 Vector UB 直连
白皮书 §4.1.4 指出,Cube Core 的 L1 Buffer 与 Vector Core 的 Unified Buffer 之间存在直接 CV 数据传递通道,并在传输过程中支持随路数值精度与数据排布转换。这样,Cube 输出不需要先绕到 L2,再由 Vector 从 L2 拉回。
对 FlashAttention 这类 Cube-Vector 交替执行的算子,CV 通道减少了 L2 层的数据交换,也降低了 Vector Core 等待输入的概率。
2.2 NDDMA 的多维排布转换
NDDMA 指令把 Global Memory 中的数据做最多 5 个维度的重排后写入 Vector UB,并同时完成搬运、转置、切片、对齐和排布转换。它硬化了地址生成逻辑,并通过内置缓存把小粒度读合并为 128 字节访问。
这类能力对编译器尤其重要:layout 变换不必完全展开成标量循环,可以映射为 NDDMA 描述符;AI Core 内部的数据搬运也可以与计算流水重叠。
3. AI Core 与 AI CPU 的缓存边界
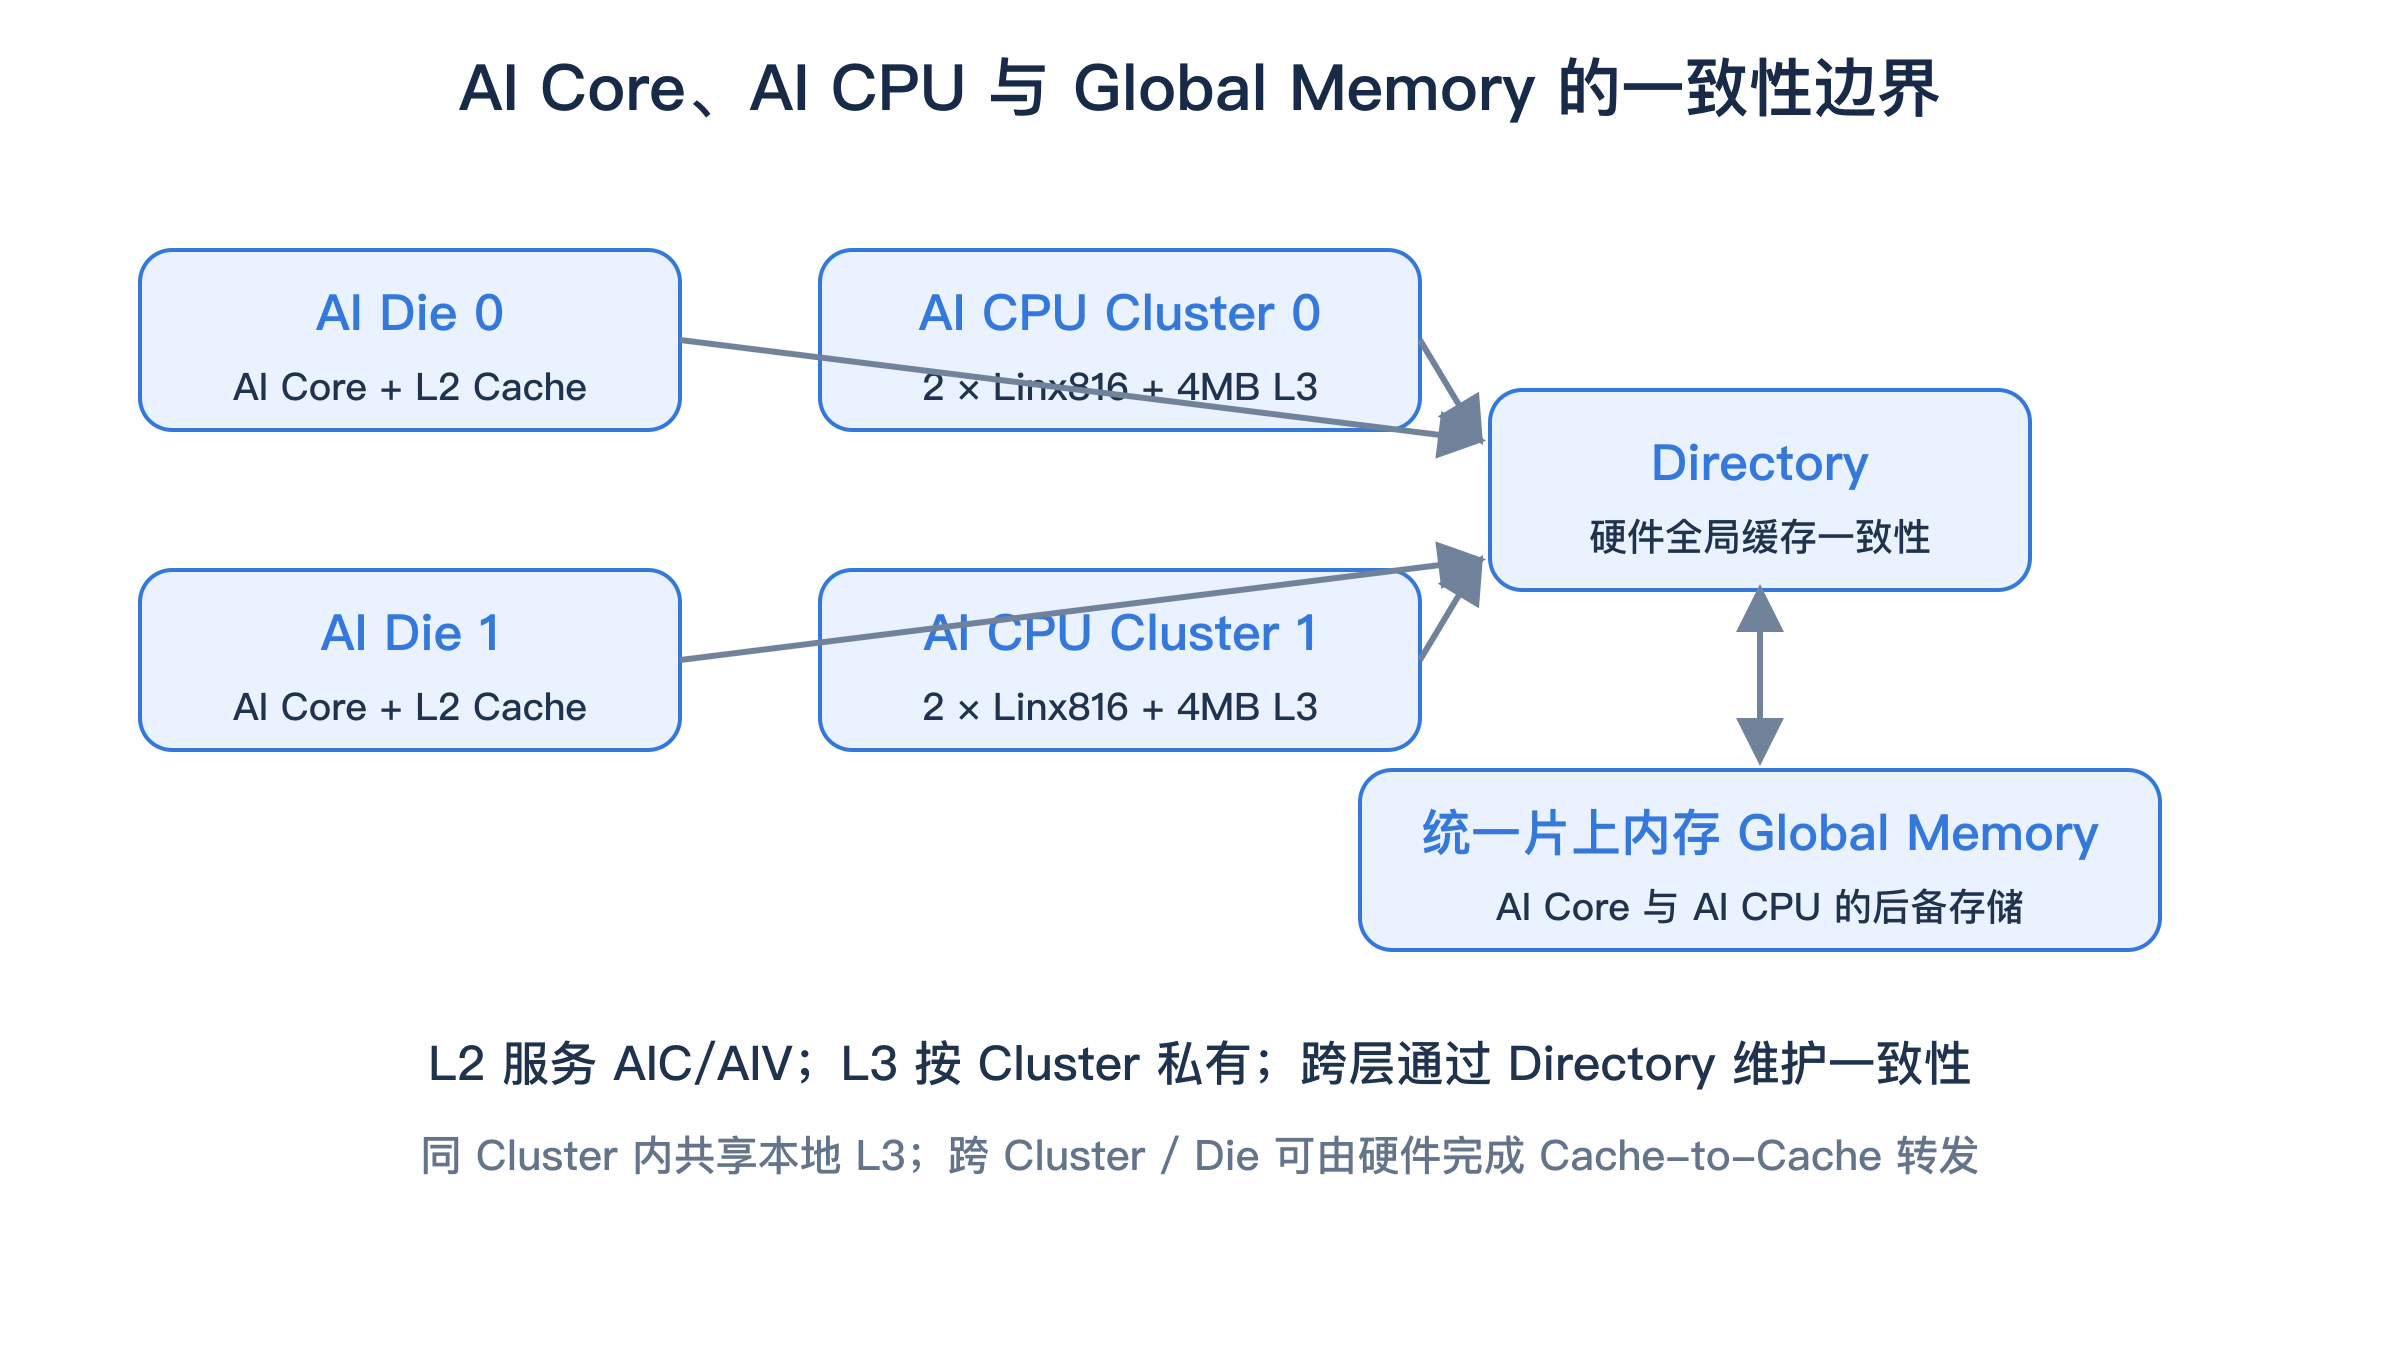
白皮书 §4.2 的关键描述是:所有 AI CPU 和 AI Core 共享统一的片上内存;AI CPU 有独立的 CPU L1/L2/L3 Cache 系统,并通过硬件支持的全局缓存一致性设计与 AI Core + L2 Cache 子系统交换数据。
3.1 各级缓存的归属
| 层级 | 服务对象 | 归属与容量 |
|---|---|---|
| L2 Cache | AIC / AIV | 最高 128MB,服务 AI Core;2 Die UMA,硬件维护跨 Die L2 一致性 |
| CPU L1/L2 | 每个 Linx816 CPU Core | L1 64KB/Core,L2 1MB/Core |
| L3 Cache | AI CPU Cluster | 4MB per Cluster,Cluster 内共享,非全芯片统一池 |
| Global Memory | AI Core 与 AI CPU | 950PR 最高 128GB / 1.6TB/s;950DT 最高 144GB / 4TB/s |
所以,AI Core 与 AI CPU 直接共享的是统一地址空间下的 Global Memory,而不是共享同一块 L2 Cache。AI CPU 也不直接挂到 AI Core 的 128MB L2 上。
3.2 L3 的分片组织
完整昇腾 950 芯片包含 4 个 AI CPU Cluster,每个 Cluster 由 2 个 Linx816 CPU Core 和 4MB L3 Cache 组成。Linx816 每核支持两个线程,因此完整规格是 8 核 16 线程。
如果把全芯片 L3 简单说成“8 个 CPU Core 共享 16MB L3”,容易误解为一个全局统一的大池子。更准确的表述是:
Cluster 0: 2 CPU Core + 4MB L3
Cluster 1: 2 CPU Core + 4MB L3
Cluster 2: 2 CPU Core + 4MB L3
Cluster 3: 2 CPU Core + 4MB L3
--------------------------------
全芯片合计:8 Core / 16 Thread / 16MB L3
按图 3-1 与图 4-9 的布局,这 4 个 Cluster 分布在 2 个 AI Die 上,可理解为每个 AI Die 上有 2 个 Cluster。AI CPU 访问自己 Cluster 的 L3 不需要跨 Die;只有访问其他 Cluster 或 Die 的数据时,才进入跨 Cluster / 跨 Die 的一致性路径。
3.3 跨 Cluster 通信路径
从逻辑地址空间看,Global Memory 是统一的后备存储和最终归宿;从物理数据通路看,跨 Cluster / 跨 Die 通信并不一定先把数据写回 DRAM,再让另一侧从 DRAM 读出来。
白皮书图 4-9 展示了 L2 Cache、L3 Cache 与 Directory 之间的关系。按常规硬件缓存一致性语义,可以分成三种情况:
- 同一 AI CPU Cluster 内:两个 CPU Core 共享本地 4MB L3,数据交换可在本地 L3 层完成;
- 跨 Cluster / 跨 Die:请求进入 Directory 参与的一致性协议,硬件追踪缓存行状态;
- 数据仍在其他 Cache 中:可能通过片上互连完成 Cache-to-Cache 转发;只有发生失效、置换、显式写回或 Flush 时,才必然落回 Global Memory。
因此,更严谨的说法是:GM 是统一地址空间的一致性后援,Directory 负责维护跨缓存层级可见性,实际数据可以在片上完成转发。
4. STARS 2.0 与分层调度
白皮书 §4.4 将 STARS 定义为全芯片的 Task 与 Resource Scheduler。它负责串接数据流与同步信息,可调度 AIC、AIV、AI CPU、DVPP、SDMA、UB、CCU 等多种引擎。
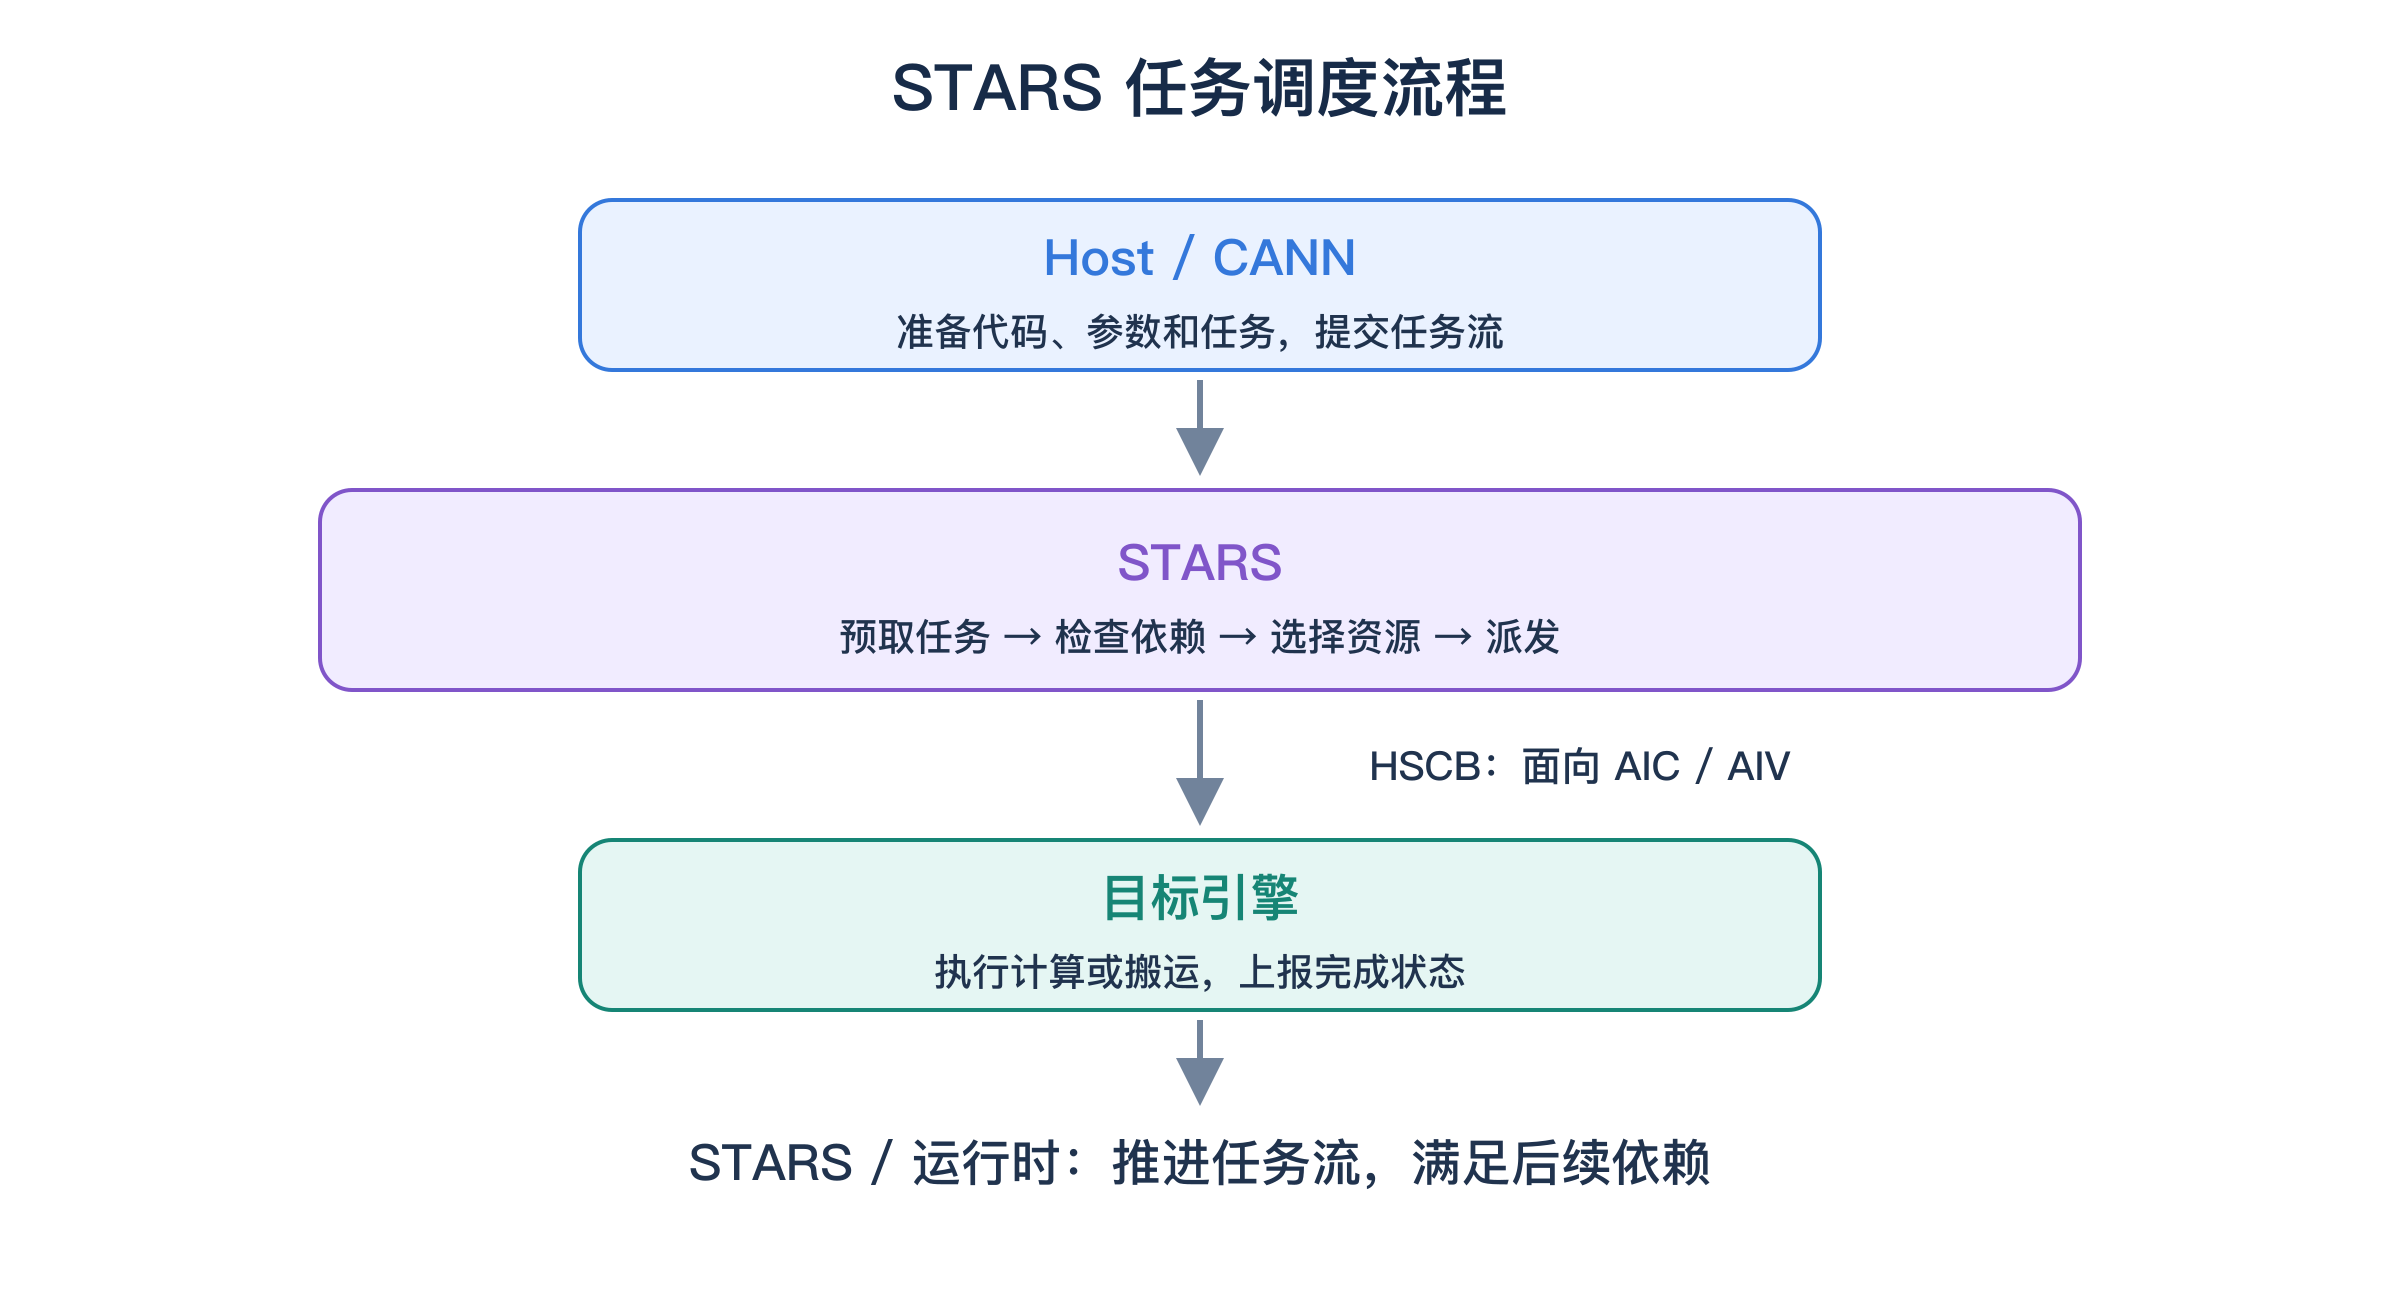
核心规格包括:
- Host 可向 Device 侧下沉 2048 条任务流;
- 并发调度最多 16 个 AI CPU 任务、64 个 Host CPU 任务;
- 最多 64 个 UB Jetty、32 个 CCU 任务、32 个 SDMA 通道;
- 最多 128K 个单比特同步标志位,或 4096 个 32 比特多比特同步标志位;
- 支持条件算子、计算融合通信任务、Group 调度与算力切分;
- 通过 HSCB 与 AIC/AIV 交互,调度开销降到 ns 级。
但这不代表所有微观控制都由 STARS 完成。真实系统中,它更像一个全局任务入口,下面还有多层局部控制器。
4.1 核内控制器
在 AI Core 内部,Scalar Unit 负责取指、译码后的任务派发,把指令送入 Cube、Vector、MTE/NDDMA 等队列。进入 SIMT 模式时,Vector Core 内的 Warp Scheduler 负责跟踪 ready warp、指令依赖、分支分化和访存挂起,并进行细粒度硬件切换。
换句话说,STARS 决定“哪个核或引擎执行哪个任务”;核内调度器决定“这个核内哪些指令或 warp 可以推进”。
4.2 CCU:集合通信的 Mission 调度
CCU 不是简单的一条 DMA 通路。它包含集合通信管理单元 CCUM,可接收 STARS 或运行时下发的粗粒度 Mission,再自主展开成 Reduce、搬运、同步等多个小任务。CCUA 中的 MemorySlice 与 Reduce Unit 配合,完成 Broadcast、AllReduce、ReduceScatter、AllGather、All2All 等集合通信算法。
这使 AI Core 不必为集合通信的控制流耗费算力。
4.3 IO 与互联控制器
URMA 侧有队列控制器,处理 Doorbell、发送队列、完成队列、流控、重传判定与仲裁。UB On-Chip Switch 则根据路由表转发跨端口流量。对于跨卡、跨节点通信,这些局部控制器让 STARS 不必介入每个包或每个队列事件。
4.4 Host 与整机侧调度
如果把视野扩展到整机部署,还会看到另一层系统调度:
- Host CPU 上的 CANN Graph Engine / Runtime 负责计算图切分、Task Graph 生成和任务流下发;
- STARS 反向调度时,Host CPU Worker 线程池可承接异步回调;
- PCIe Switch 负责主机与多张 NPU 卡之间控制流和 Doorbell 的低延迟透传;
- BMC 负责功耗、温度、故障隔离、复位等带外管理。
这部分是工程部署视角的补充,核心思想与白皮书中的软硬件协同一致:全局调度中心负责任务流和资源编排,各引擎内部保留专用控制器,避免所有微观事件都穿越同一层控制总线。
5. 对算子与编译器的影响
把这些架构事实翻译成优化策略,可以得到四条比较直接的结论。
5.1 让 RegFile、UB 和 NDDMA 形成三级流水
对向量算子,不能只写“从 GM 读到 UB,再计算”。更细的目标是:
NDDMA: GM / L2 → UB       # 大块、异步、多维排布转换
LSU:   UB ↔ RegFile       # 核内 load/store,与计算双发射
ALU:   RegFile → RegFile  # 计算、转换、规约
编译器需要显式管理三级数据生命周期:哪些数据留在 RegFile,哪些驻留 UB,哪些需要经过 L2 hint 或 SDMA CMO 控制。
5.2 按 VF 特征选择 SIMD/SIMT
对规则稠密循环,优先 SIMD,并让计算与 load/store 配对;对 gather/scatter、hash、复杂分支,允许映射为 SIMT。编译器可以把一个 fused operator 拆成多个 VF,每个 VF 单独选择执行模式,而不是给整个 kernel 做二选一。
5.3 CV 融合要减少 L2 往返
对 FlashAttention、量化 GEMM、layout 变换密集的算子,优先把 Cube 输出通过 CV 通道交给 Vector,并利用随路转换完成精度变化和排布变化。只有跨 AI Core、跨 Die 或生命周期较长的数据才应该落到 L2 / GM。
5.4 数据可见性交给 Directory,通信路径仍要区分层级
AI Core 与 AI CPU 共享统一 Global Memory,且硬件维护一致性,但这并不意味着所有通信都等价。同 Cluster 内 L3 共享、跨 Cluster / Die 走 Directory、跨卡走 UB/URMA、跨主机走 PCIe 或以太网。编译器和运行时应根据数据生命周期与访问频率选择路径,而不是把 GM 当成万能中转站。
6. 关键边界速查
| 主题 | 关键事实 |
|---|---|
| Vector Core 双发射 | 核内 ALU 与 Load/Store 流水线并发;MTE/NDDMA 是独立异步搬运引擎 |
| 16MB L3 | 4 个 Cluster 各自私有 4MB L3;全芯片合计 16MB,不是全局共享池 |
| AI Core 与 AI CPU | 共享统一 Global Memory;AI Core 用 L2,AI CPU 用独立 L1/L2/L3,由 Directory 维护一致性 |
| 跨 Cluster 通信 | GM 是后备存储;Directory 可维护状态并支持片上 Cache-to-Cache 转发 |
| STARS 调度 | STARS 是全局任务与资源调度中心;核内、CCU、URMA、UB Switch、Host 与 BMC 各有局部控制器 |
7. 小结
昇腾 950 的性能提升是指令、存储、调度三层同时升级:
- Vector Core 从 Memory-Based SIMD 走向 Register-Based 双发射与乱序执行,FP16/FP32 单核算力翻倍;
- SIMD/SIMT 混合编程让规则稠密计算和离散访问各得其所;
- CV 通道、NDDMA 和 RegFile 把数据搬运与转换压进核内流水;
- AI Core 与 AI CPU 共享 Global Memory,但缓存层级物理分离,跨层一致性由 Directory 维护;
- STARS 2.0 之外存在分层调度器,全局任务编排与局部自治并行。
对 AI 编译器而言,950 的硬件模型比“更多算力”更具体:编译器必须同时管理执行模式、寄存器与局部存储、layout 转换、缓存驻留、任务依赖和通信路径。。
参考资料
- 昇腾 950 NPU 架构白皮书:§3 架构概述,§4.1 AI 子系统,§4.2 AI CPU 子系统,§4.3 Memory 子系统,§4.4 STARS 2.0。